當全球人工智慧的浪潮以驚人速度從單純的語言對話模型,演進至具備自主規劃、工具調用與複雜多步驟執行能力的代理式AI(Agentic AI)時代,半導體產業的競爭焦點也迎來了根本性的典範轉移。
過去數年間,市場往往聚焦於單一GPU晶片的尖峰算力與封閉專有軟體體系的護城河。然而,隨著大模型參數量邁向萬億級別、企業運算需求向邊緣端快速擴散,單一晶片的暴力堆疊已無法解決高昂的總擁有成本、功耗牆以及嚴苛的供應商鎖定隱憂。
在這樣的產業轉折點上,AMD展現出極具戰略縱深的佈局。透過近年來精準的技術收購與自研架構創新,AMD正式將算力版圖從資料中心超大規模機櫃、企業混合雲、桌面端AI PC,一路貫穿至實體機器人領域。更重要的是,AMD選擇了一條與封閉體系截然不同的道路—以開放標準為經、跨界巨頭共研為緯,號召全球雲端大廠、AI獨角獸與生態夥伴,組建起橫跨硬體、軟體與系統級架構的全新聯盟。
這場算力版圖的重構,正宣告一個由開放生態所主導的AI新時代正式降臨,而AMD正以成熟的技術底蘊與開放胸襟,穩步加冕為次世代AI生態的新盟主。
走向推論與代理人爆發期
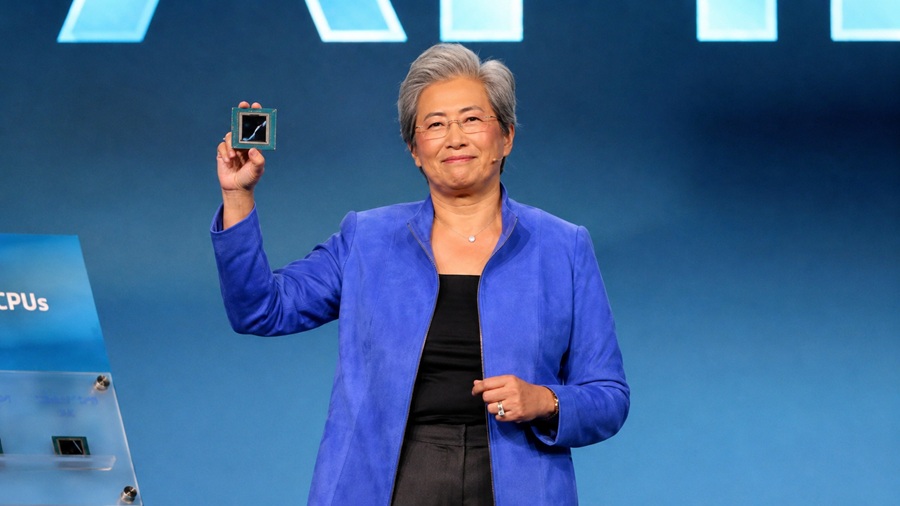
要理解AMD為何能在現階段迅速崛起,必須先洞察整體AI市場結構的劇烈質變。AMD董事長暨執行長蘇姿丰博士明確指出,全球AI算力消耗正呈現出驚人的指數級增長。過去短短兩年間,全球每月消耗的Token數量激增了近160倍,達到每月超過35 Quadrillion的龐大規模。
|
更關鍵的轉折在於運算型態的遷移。產業早期多數算力集中於基礎模型的預訓練,但隨著大模型全面進入商業化應用,全球已有超過60%的AI運算資源轉向推論。與此同時,Agentic AI的崛起徹底改變了推論的工作負載特性。代理人不再只是單次性的文字生成,而是需要反覆進行邏輯推理、存取企業資料庫、調用外部API並即時校正輸出。這種長上下文、多步驟、高併發的工作流程,對記憶體容量、記憶體頻寬以及CPU與GPU之間的協調能力,提出了更為嚴苛的要求。
針對這樣的趨勢,AMD預測至2030年,全球純AI加速器市場規模將攀升至1.4兆美元,伺服器CPU市場將突破2,000億美元,而包含邊緣與自適應運算在內的整體高效能運算潛在市場更將直逼2兆美元大關。面對如此龐大的市場大餅,沒有任何單一廠商能以封閉規格獨吞所有需求,唯有具備端到端完整產品組合與開放相容性的架構,才能真正支撐起下一世代的AI基礎設施。
旗艦武器Helios--從晶片供應商進化為機櫃級算力的定義者
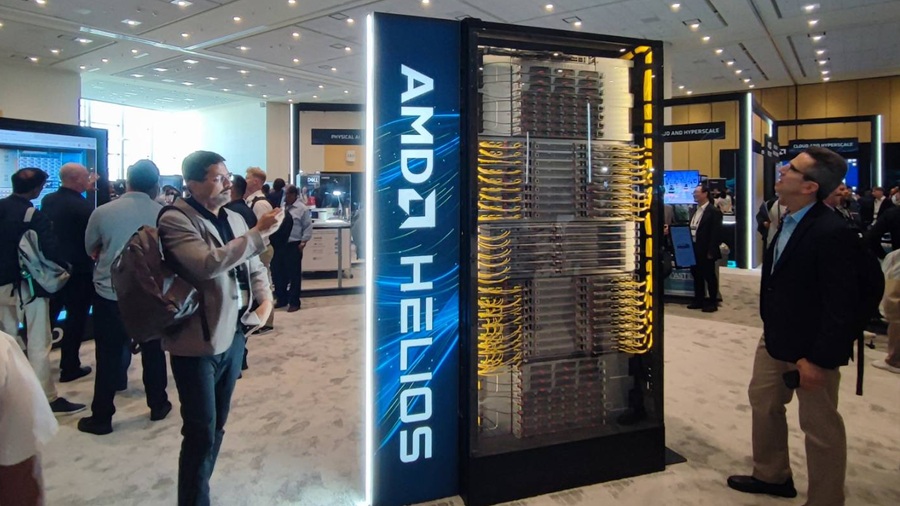
面對萬億參數模型的訓練與超大規模推論需求,AMD所打出的最強王牌,便是將整座機櫃視為單一巨大運算單元的旗艦級架構—Helios。
Helios的誕生,代表AMD正式從單純供應加速卡與處理器的半導體元件商,躍升為能夠定義資料中心系統級標準的架構引領者。在現代超大規模資料中心內,伺服器面臨嚴重的供電限制與散熱瓶頸,客戶不再希望耗費數月時間自行拼裝散熱、網路與伺服器節點,而是需要開箱即用、具備極致能效比的機櫃解決方案。
|
在硬體系統層面上,Helios機櫃高度整合了CDNA 5架構的Instinct MI455X加速器,搭配基於Zen 6微架構的第6代EPYC伺服器處理器“Venice” 作為大腦,並結合Pensando Vulcano 800 AI NIC網路晶片,實現機櫃內部極低延遲的資料吞吐。
這種全方位整合為資料中心帶來了直擊痛點的商業競爭優勢。單一Helios機櫃整合了高達31 TB的HBM4記憶體,較競品多出約50%的容量與頻寬,使超大型模型推論能夠大幅減少跨節點通訊的延遲。在資料中心最核心的每瓦效能與每美元Token產出量指標上,Helios提供了高達30%以上的成本效益提升。更關鍵的是,不同於封閉陣營仰賴專有的傳輸介面與封閉交換器,Helios在機櫃內部採用開放的UALink標準,在跨機櫃網絡則全面導入Ultra Ethernet Consortium超乙太網路標準,徹底打破了硬體綁定的枷鎖。
以Gorgon Halo引領個人端與邊緣AI變革
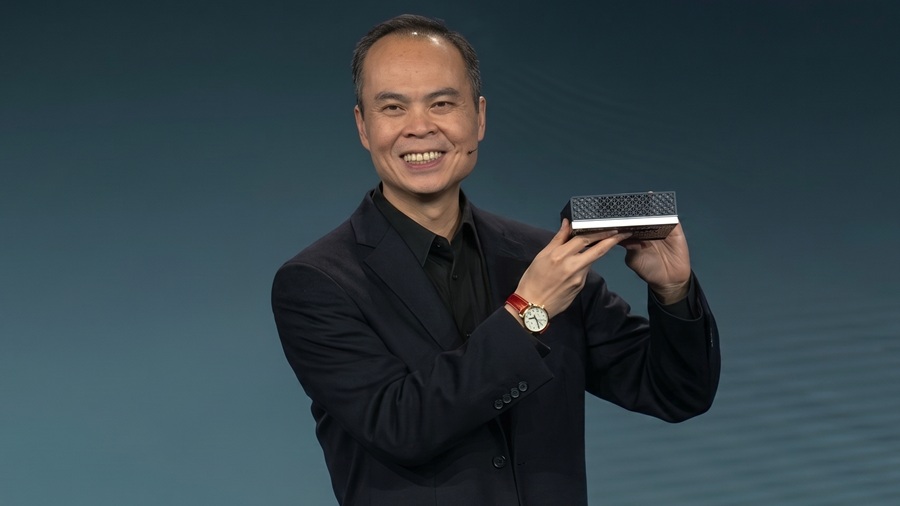
AMD的盟主思維並未止步於雲端機房。在生態版圖的另一端,AMD敏銳地洞察到,如果所有的AI推論都必須依賴雲端,企業將面臨難以承受的網路頻寬成本、隱私外洩風險與延遲問題。真正的普及化AI,必須將強大算力延伸至每一位開發者與專業人員的辦公桌上。
|
然而,長期以來本地端PC運行大模型的最大瓶頸並非純運算能力,而是消費級顯示卡的顯存容量限制。針對此痛點,AMD將運算架構創新延伸至桌面終端,推出了搭載高頻寬統一記憶體的Ryzen AI Max系列平台。以「Gorgon Halo」為原代號的Ryzen AI Max PRO 400系列,進一步將本地端AI運算的記憶體容量推升至新高度。
這款平台將統一記憶體容量一舉推升至192 GB,其中高達160 GB可直接分配作為GPU顯存使用。這項突破使得過去需要多張高階伺服器加速卡才能載入的200B~300B以上參數等級開源大模型,如今開發者在個人桌上型電腦即可直接進行原生微調、測試與推理,免除了高昂的雲端租賃費用。
為了讓邊緣算力能迅速轉化為生產力,AMD同步展開了廣泛的軟體與平台結盟。除了深化開源社群合作,為購買Halo設備的開發者提供開箱即用的Hugging Face模型支援與整合體驗之外,更攜手網路巨頭Cisco,將Cisco Cloud Control安全管理機制導入AMD桌面設備。這使企業資訊長在部署地端AI代理人時,能夠精準監控Token成本消耗並建立安全防護網,徹底解決企業導入地端AI時的資安與治理痛點。
|
延伸至實體AI--Kria AI平台與機器人夥伴網路
當人工智慧走出螢幕、進入實體物理世界,機器人與實體AI便成為自適應運算與高效能晶片的下一個主戰場。以往在機器人領域,處理馬達控制、感測安全與運動規劃的身體,與負責高階視覺辨識與多模態決策的大腦,往往是由互相割裂的晶片與軟體系統組成。
|
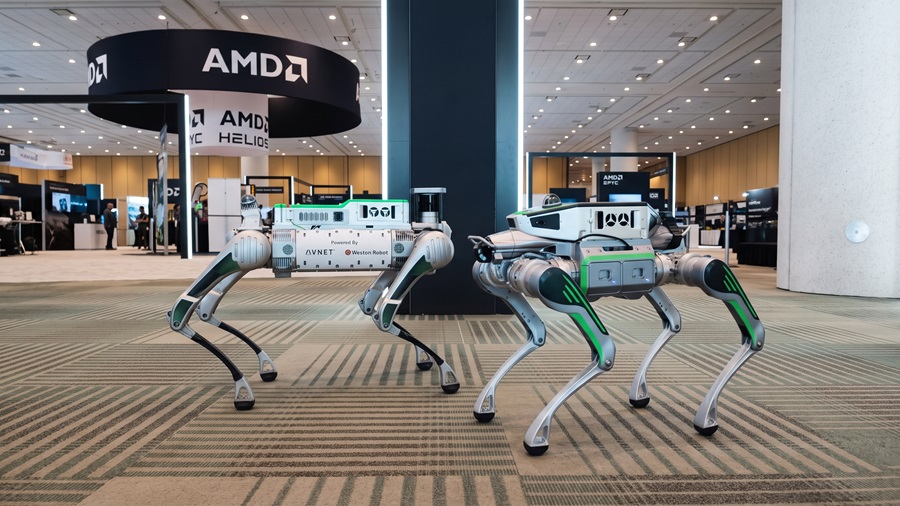
AMD憑藉自適應運算所打下的深厚基礎,正式推出了專為次世代自主機器人打造的AMD Kria AI解決方案,將運算優勢從傳統的運動控制身體正式擴展至具備多模態推理能力的大腦。Kria AI系統模組採用標準化COM-HPC規格,搭載Ryzen AI嵌入式X100系列處理器,單一晶片內高度整合了16核心Zen 5 CPU、RDNA 3.5繪圖核心與高效能NPU,並結合自適應SoC與FPGA模組。這種異質架構實現了統一記憶體管理,不僅能達成小於100毫秒的視覺、語言、行動多模態推理響應,更能維持每秒超過8,000次的超高頻率確定性即時控制。
在實際應用效能上,Kria AI 平台與競品相比,在機器人關鍵工作負載上展現出即時可靠性提升3.4倍、閒置運算餘量增加1.6倍的優勢,並支援高達2.3倍的並行代理數量。為了破除封閉軟體壁壘,透過相容ROS 2與ROCm的開放機器人軟體套件,AMD提供了高效率的程式碼移轉工具鏈,經實測能保留高達75%的現有CUDA原始碼,大幅降低開發團隊的重構負擔。同時,AMD成立涵蓋感測器大廠、ODM/OEM製造商、獨立軟體供應商與系統整合商的機器人合作夥伴網路,透過免費註冊、模組化參考設計與全方位算力支援,正在實體AI領域複製其開放生態的成功模式,打通從演算法研發到工廠量產的最後一哩路。
頂級巨頭共同背書的最強AI隊
一個新生態盟主的確立,最關鍵的指標不在於企業自身的宣傳,而在於產業中最具影響力的客戶與合作夥伴將關鍵工作負載押注於何處。在當前的AI競爭格局中,全球科技巨頭最迫切的需求便是尋求能夠擺脫單一供應商鎖定、具備高度定制彈性且軟硬體成熟的第二支柱。AMD的開放路線與協同設計哲學,正好成為全球頂尖AI機構的共同解答。
|
前沿AI實驗室的算力轉向正是最佳例證。大模型領先者Anthropic宣佈將大規模部署高達2GW的AMD Helios機櫃系統,用以支撐其Claude次世代模型的研發與商業推論,為AMD的機櫃級架構提供了最具說服力的百億級算力背書。OpenAI基礎設施團隊亦公開證實,已在AMD Helios與Instinct MI400系列加速器上深度運行GPT級別的旗艦工作負載,並高度評價AMD硬體在底層編譯器優化與推論吞吐量上的快速進展。
與此同時,Meta基礎設施負責人回顧了雙方跨越四代EPYC CPU與Instinct GPU的深度共研歷程,強調AMD在客製化架構、功耗控制與開源基礎設施上的緊密配合,是Meta構建全球超大規模社群推論系統的重要基石。
除了硬體產品線的擴展,AMD透過持續的戰略性技術收購,不斷豐富自身的底層架構工具庫。在軟體層面,新推出的ROCm.AI平台導入了AI輔助程式碼生成技術,使開發者能自動優化GPU核心運算元,大幅簡化跨平台移植門檻,真正實現了新模型發布當天的即時相容性。
開放生態成就次世代AI霸業
回顧半導體與運算科技的發展史,封閉體系往往能在技術萌芽期憑藉垂直整合迅速取得先機,但當技術邁向成熟、市場規模擴展至數兆美元的普及應用階段時,最終引領產業前行的,必然是具備高包容度、跨產業協同與防壟斷特性的開放標準生態。
從資料中心動輒數萬顆GPU協同運作的Helios機櫃,到打破顯存瓶頸、將3,000億參數模型搬上辦公桌的Gorgon Halo;從賦予機器人智慧大腦的Kria AI異質運算平台,到串聯Anthropic、OpenAI、Meta等產業巨擘的開放夥伴網路,AMD已經構築起一幅從雲端、邊緣到實體物理世界的完整AI全方位版圖。
不打封閉獨角戲,而是攜手整個產業鏈共同做大市場大餅;不追求單一廠商鎖定,而是以極致的TCO效益、統一記憶體架構與開放標準賦能每一位客戶。AMD正以清晰的戰略定力、深厚的硬體底蘊與前瞻的生態號召力,昂首邁向AI算力新時代的盟主寶座。

軟體定義汽車的隱形瓶頸:為何少了數位雙生就跑不動?
汽車產業正從「硬體定義」走向「軟體定義」。這不只是技術升級,更代表沿用數十年的研發流程、組織分工與供應鏈協作模式,都必須重新調整。 軟體定義汽車(Software-Defined Vehicle…
汽車產業正從「硬體定義」走向「軟體定義」。這不只是技術升級,…
 相關作者
 相關關鍵字